
Day28 說了跨站流量與故障切換。當服務出現 timeout、502 或 503,可能卡在名稱解析、建立連線、入口路由,也可能是 Pod 或下游回應太慢。
今天用 gateway 呼叫 api-a 的情境,把幾個常見的檢查位置與機制說清楚。
開始調整設定前,先保留失敗的時間、URL、狀態碼與完整錯誤訊息。再分成兩種情況:
gateway 呼叫 api-a 失敗,就從呼叫端所在的 Pod、實際請求與 log 開始查。ImagePullBackOff 表示拉取失敗後正在延後重試。image 名稱、授權、憑證、網路與 DNS 都可能造成失敗,具體原因要看 Events。
Node 拉取 image 時,使用的是 Node/runtime 所在環境的解析設定。一般 Pod 則由自己的 DNS 設定決定查詢路徑;常見的 ClusterFirst 配置會透過叢集 DNS 解析 Service 名稱,通常由 CoreDNS 提供服務。
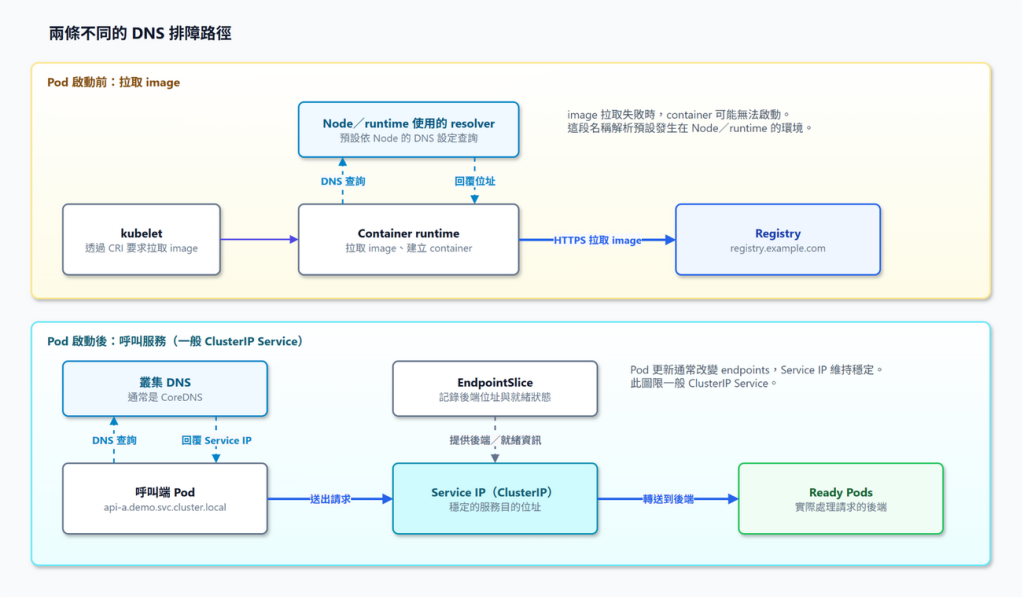
同一個名稱在自己的電腦、Node 與 Pod 裡,可能使用不同的 resolver。問題出在 gateway 裡,就盡量從相同的環境測試。
假設 gateway 與 api-a 位於 demo Namespace,api-a 使用一般 ClusterIP Service,以 8080 port 提供 /health。呼叫端可以用同 Namespace 的短名稱 api-a,或完整名稱 api-a.demo.svc.cluster.local;叢集網域以實際設定為準。
其中幾個角色分別處理:
port、targetPort 與 selector。同一個 Service 存續期間,ClusterIP 通常維持不變。Pod 被替換時,Pod IP 的變動會反映在 EndpointSlice,呼叫端繼續使用原本的 Service 名稱。
這篇先聚焦一般 ClusterIP Service;Headless Service 可以直接回覆 Pod 位址,行為另有差異。
先確認 gateway 使用的 DNS,再查名稱與 HTTP 回應:
kubectl -n demo exec deploy/gateway -- cat /etc/resolv.conf
kubectl -n demo exec deploy/gateway -- nslookup api-a.demo.svc.cluster.local
kubectl -n demo exec deploy/gateway -- curl -v --connect-timeout 3 --max-time 10 http://api-a:8080/health
指令假設容器具備這些工具,多 container 的 Pod 要選對 container。也可以用診斷 Pod,留意它的 Namespace、NetworkPolicy 與 proxy 配置是否接近原呼叫端。
觀察時可以分開看:
HTTPS 的 DNS 位址、TLS SNI 與 HTTP Host 各有用途。測試時保留原網域,改成 IP 可能改變 TLS 或路由行為。
再檢查服務與後端:
kubectl -n demo get svc api-a -o yaml
kubectl -n demo get endpointslice -l kubernetes.io/service-name=api-a -o yaml
kubectl -n demo get pods -l app=api-a -o wide
這裡假設 Service selector 使用 app=api-a,重點看:
port 與 targetPort 是否對應程式監聽的連接埠。conditions.ready 是否符合預期。Pod 顯示 Running 時,仍要把就緒條件與實際請求一起看。服務轉送也會受到叢集網路元件與 NetworkPolicy 影響。
有時診斷工具測試已正常,程式卻還在連舊位址。這時可以分清兩件事:
沿用前一天的外部 API 網域情境,假設 api.example.com 的 DNS 回答從 A 改成 B。程式如果仍重用連到 A 的既有連線,就可能繼續向 A 發出請求。重新建立連線時,才有機會取得更新的解析結果。
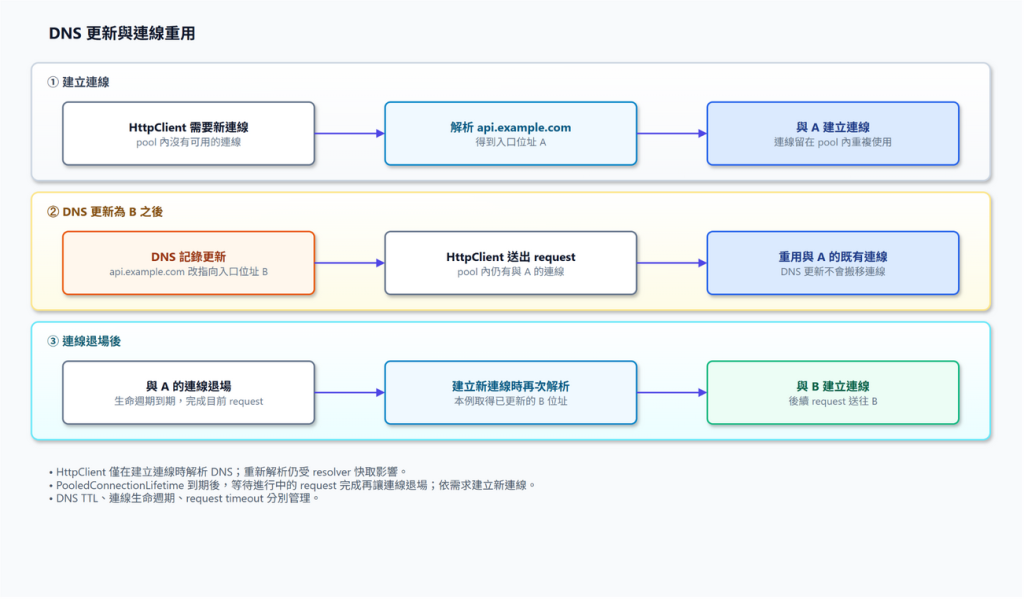
以 .NET 的 HttpClient 為例:
PooledConnectionLifetime 可以限制連線被沿用的時間。達到生命週期並完成目前相關請求後,連線會退場;需要新連線時再解析 DNS。IHttpClientFactory 管理 handler 與連線池。每個請求都直接 new HttpClient(),再釋放它與所屬連線池,可能增加成本或耗盡連接埠;factory 建立的 client 可重用 handler 與連線池。設定值要依 DNS/網路變動頻率與服務需求選擇。重新解析仍會受到 resolver 快取影響,DNS TTL、連線生命週期與 request timeout 分別管理。
前面一般 Service 的 Pod 更新,主要由 endpoints 更新處理。這裡的 DNS 變動以外部網域為例;既有連線的恢復,另看結束、失敗與重連行為。
如果請求經過 Nginx,也要看它如何取得與更新 upstream 位址:
proxy_pass/upstream 寫法,確認何時解析主機名稱。resolve 時,要搭配 resolver 與共享的 zone;Nginx 開源版從 1.27.3 起支援這項能力。proxy_pass 也有自己的名稱解析與 URI 處理方式,調整時一起確認 Host 與轉送路徑。Istio 可以提供流量路由、逾時與重試,作用範圍取決於請求是否經過對應 proxy,以及設定是否命中。應用程式的 DNS 查詢、proxy 的服務探索與 Node 拉取 image,各有自己的處理路徑。
最後調整 timeout 與 retry 時,我會先看三件事:
先記錄症狀、找出查詢與連線發生的位置,再依 DNS、服務後端、代理與連線池逐段確認。這樣調整設定時,就能知道這次改動要解決哪一段問題。


 iThome鐵人賽
 看影片追技術